株価予測が「よく当たる」って、どういうこと?
「この方法なら、株価をかなり正確に予測できる」と聞いたら、少し気になりませんか。
でも、その予測はいつ出されたのでしょう。何年も前に予想した価格でしょうか。それとも、昨日の値動きまで見て予想した、今日の価格でしょうか。
天気予報でも、来月の天気を今まとめて予想するのと、毎晩更新される明日の予報を見るのとでは、期待する正確さが違います。株価の予測も、まずはこの違いから考えると、研究の数字が読みやすくなります。
今回紹介するのは、Davide Pandiniが米国株に関係する金融商品の価格を予測し、いくつかの方法を比べた研究です。興味深いのは、過去の値動きから方法を選ぶときの採点ルールによって、その後の翌日予測でも一番になった方法と、そうならなかった方法に分かれたことです。
今回の記事では、小さな価格の例と図を使って、「よく当たる」という言葉を受け止める前に、何を確かめればよいかを見ていきます。結果を比べる表は説明のそばに置き、詳しい数値は末尾の補足にまとめました。
出典:Davide Pandini, Prediction Is Very Difficult: Especially if It’s About the Financial Markets!(Part II)、IFTA Journal 2026、pp.26–38。原論文PDF
1. 研究で予想したのは、どんな商品の価格?
研究の対象は「SPY(スパイ)」という金融商品です。
米国の大きな会社の株価の動きをまとめて表すものに、「S&P 500」という指数があります。ニュースで見る、米国株全体の動きを知るためのものさしの一つです。
SPYは、この指数に連動することを目指した投資信託です。株式と同じように市場で売買できるタイプなので、ETF(上場投資信託)と呼ばれます。ここでは「米国の大きな会社の株価の動きに連動することを目指す、売買できる商品」と捉えてください。
この研究が予想したのは、SPYという商品の、一日の取引が終わった時点の価格です。
図1では、「米国株の動きを表す指数」から「売買できる商品」、そして「研究で使う価格」へと順にたどります。
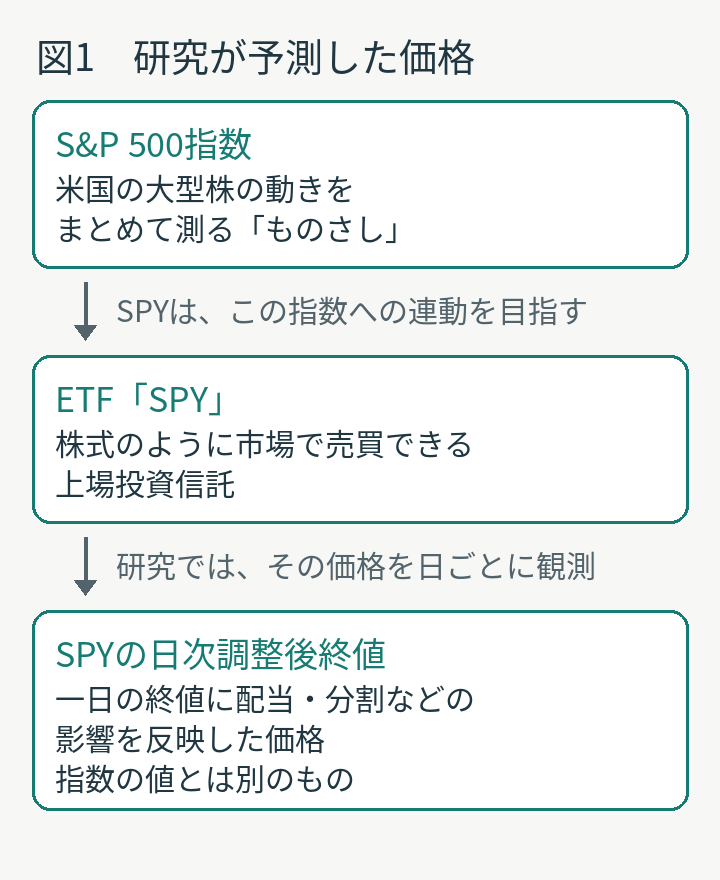
正確には、配当や株式分割などの影響を反映した「調整後終値」を使っています。過去の価格と比べるための調整が入った、一日の終わりの価格です。指数そのものの数字と、SPYの価格は別物です。
2. 今日の値動きを、明日の予想にどう取り入れる?
説明用に、価格が100だった商品を考えましょう。ここを図では「0日目」と呼びます。翌日、価格が104になりました。
明日の価格を予想するとしたら、ずっと100のままでは、今日の上昇を無視してしまいます。そこで、これまでの見積もりを104のほうへ近づけます。ただし、以前の見積もりも一部残します。
この例では、新しい価格を6割、前の見積もりを4割の割合で混ぜます。すると、明日に使う新しい見積もりは102.4になります。
今日分かった価格を取り入れて、明日の予想を直す。まずは、この順番を押さえましょう。
図2には計算も載せていますが、最初は「価格が分かる→見積もりを直す→翌日に使う」という矢印の順番を追ってください。図では、この見積もりを「基準」と表記しています。
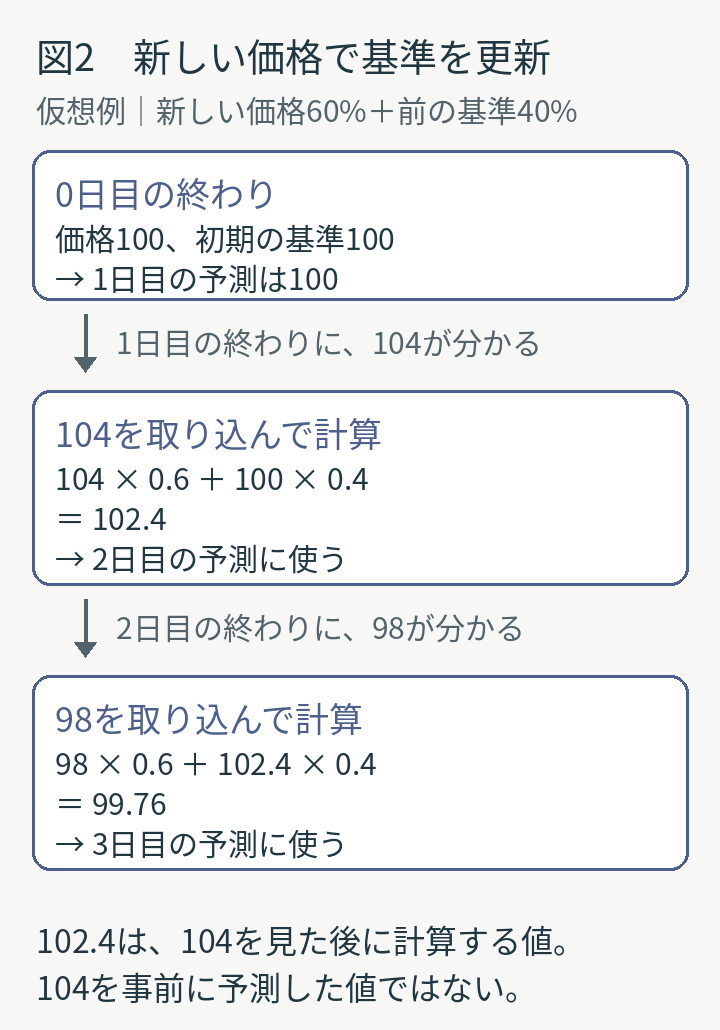
ところが、次の日の価格は98でした。102.4という予想は外れました。98が分かった後で、今度はその次の日の見積もりを99.76へ直します。後から見積もりを直せても、98を事前に当てたことにはなりません。
このように、新しい価格を重視しながら、前の情報も残す方法を「指数平滑法」といいます。前の情報は見積もりの中に残り、更新を重ねるほど影響が薄れていきます。論文の「Brown(ブラウン)」は、この基本形です。
この方法の良さは、「なぜ、その予想になったのか」を順に追えるところにあると思っています。難しい仕組みを知らなくても、今日の価格を取り入れて予想を修正したことが分かります。ただ、作り方が分かりやすいことと、予想がよく当たることは別ものです。図の計算ができたところで、将来の価格が分かったわけではない。この区別は意識しておくべきかなと思います。
なお、6対4という混ぜ方は記事の説明用です。この割合を「係数」と呼びますが、研究では、どの割合を使うかも過去のデータから決めています。
3. 練習でうまくいっても、本番で当たるとは限らない
問題集の答えを見ながら解き方を直すことと、初めて見る問題を解くことは違います。答えを覚えていれば問題集では正解できても、それだけで初めての問題にも強いとは言えません。
価格の予測でも、同じことに気を付けます。過去の値動きにうまく合うよう方法を調整したら、その調整に使っていない後の期間で、予想が実際の価格に近かったかを確かめます。
方法を整えるために使った期間と、予測を試す期間を分けています。
この研究は約19年分の価格データを使いました。その全部で予測を試したわけではなく、前半を方法の調整に、後半を予測の確認に使っています。前半が「訓練期間」、後半が「検証期間」です。図3は、二つの期間の役割を読むための図です。
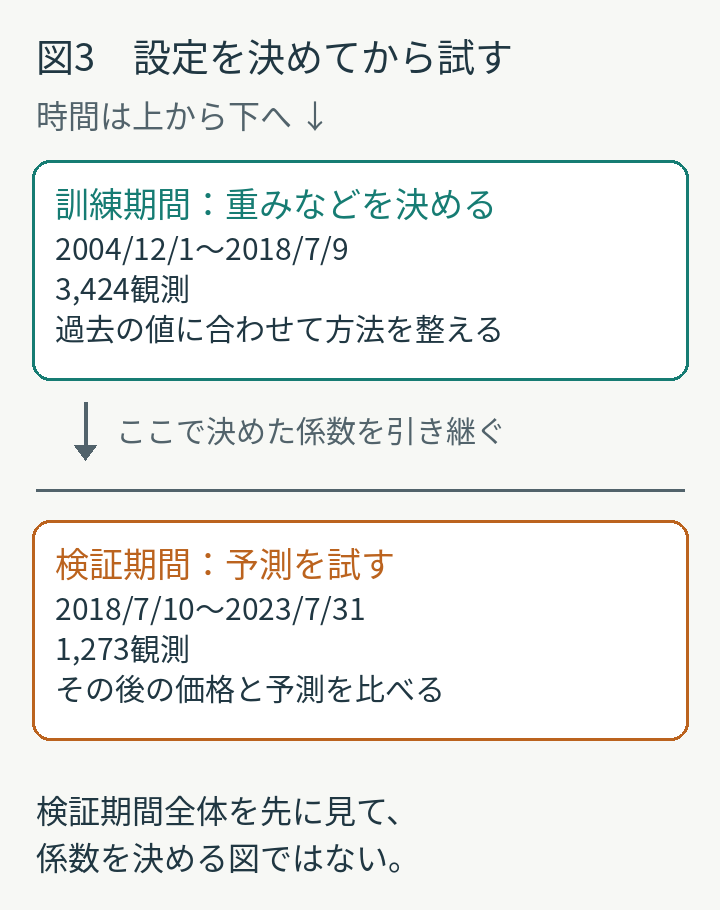
たとえば図2の「新しい価格を何割取り入れるか」も、前半のデータから決めます。後半の答えを先に見て、都合のよい割合へ選び直すわけではありません。
4. 先をまとめて予想するか、毎日、明日を予想するか
次は、冒頭の天気予報の話です。
月初に、その月の毎日の気温をまとめて予想するとします。一方、毎晩その日までの気温を見て、翌日の気温だけを予想することもできます。後者には、月初には分からなかった情報があります。
この研究も、次の二つを分けています。
- 先をまとめて予想する。 検証が始まる時点で、その先の全期間の価格を予想します。
- 新しい価格を見て、翌日だけを予想する。 一日分の価格が分かるたびに、次の取引日の予想を作ります。
同じ方法でも、いつまでの情報を使って、どれくらい先を予想するかで、条件が変わります。
図4は、この違いを図2と同じ例で示しています。上段は最初の100だけで先を予想します。下段は104が分かった後、その情報を明日の予想へ取り込みます。図の下の「固定」は先をまとめて予想した場合、「更新」は新しい価格を見て翌日を予想した場合を指します。
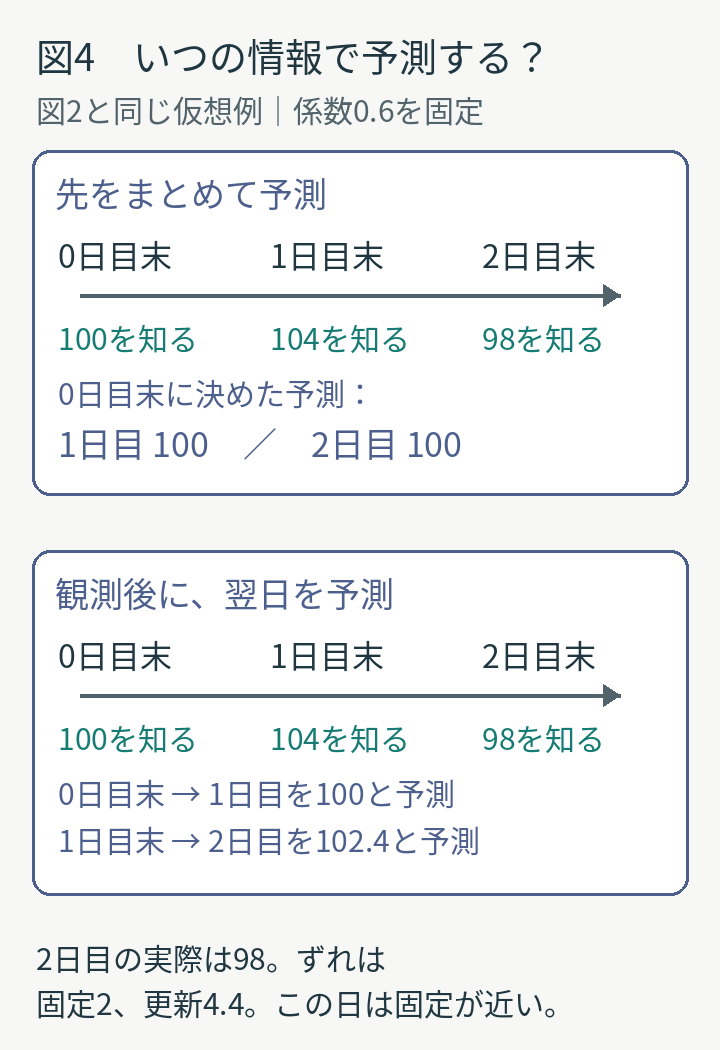
この例では、二日目の実際の価格は98でした。100とした上段のほうが、102.4とした下段より近くなっています。
この図を見ると、「新しい情報を使うほうが、いつも正しい」とは言えないことが分かります。予想を直せることには良さがある一方、それが必ずしも正解には繋がらなず、この論文を読む際には、内容自体が改善の保証にはならないと考えたほうがいいのかなと思っています。研究の成績を比べるときも、当たった数字だけでなく、そこまでに何を知っていたかに目を向けると、結果の意味が見えやすくなるでしょう。
なお、ここで変えているのは、取り込む価格です。6対4という混ぜ方は同じままでも、予想の数字は変わります。混ぜ方そのものを選び直すこととは、分けて考えてください。論文の翌日予測も、前半で決めた係数を再推定せずに行っています。
5. 「よさそうな方法」と「よく当たった予想」を分ける
方法を選ぶ段階では、過去の値動きにどれだけ合うかを見ます。ただ、細かい設定をいくつも足せば、過去の動きに合わせやすくなる場合があります。だからといって、後の予想も上手になるとは限りません。
そこで、過去の動きへの合いやすさと、仕組みが複雑すぎないかを一緒に見て、方法を選びます。
選び終えたら、今度は実際に予想した価格と、後から分かった本当の価格を比べます。ここで知りたいのは、「どのくらいずれていたか」です。
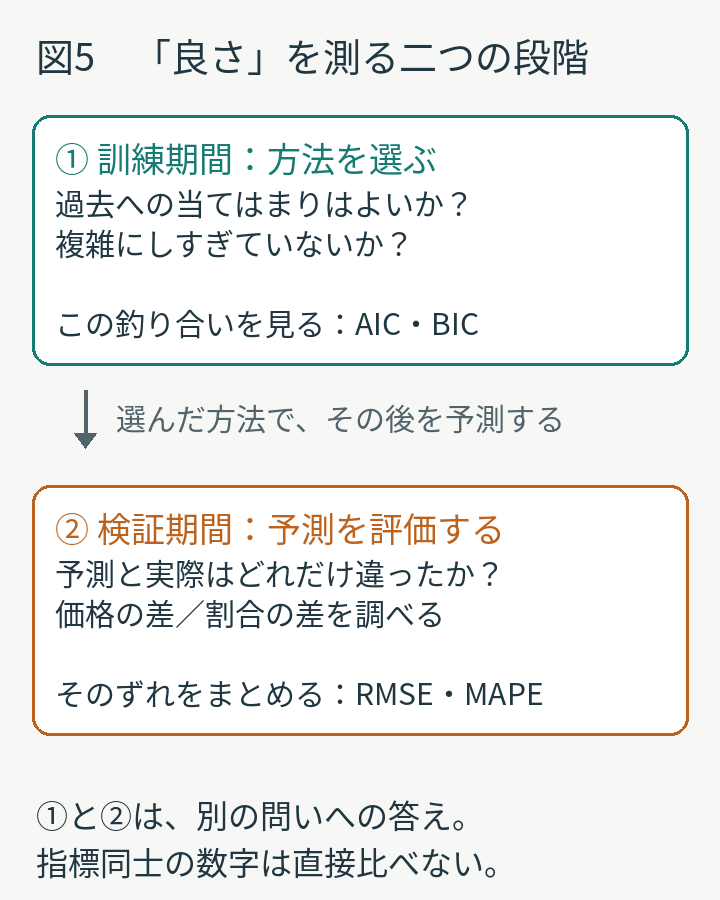
方法を選ぶための点数と、後で予測のずれを確かめた数字は、別のものです。
図5では、上段のAIC・BICが「方法を選ぶ点数」、下段のRMSE・MAPEが「予測のずれをまとめる数字」です。まずは、二つの段階の役割が違うところを見てください。計算方法などは末尾の補足でも確認できます。
「ずれ」は、難しく考えなくて大丈夫です。図2で102.4と予想した日の実際の価格は98でした。この差の4.4が、その日のずれです。研究では「誤差」と呼びます。図6は、この二つの価格の差を示しています。
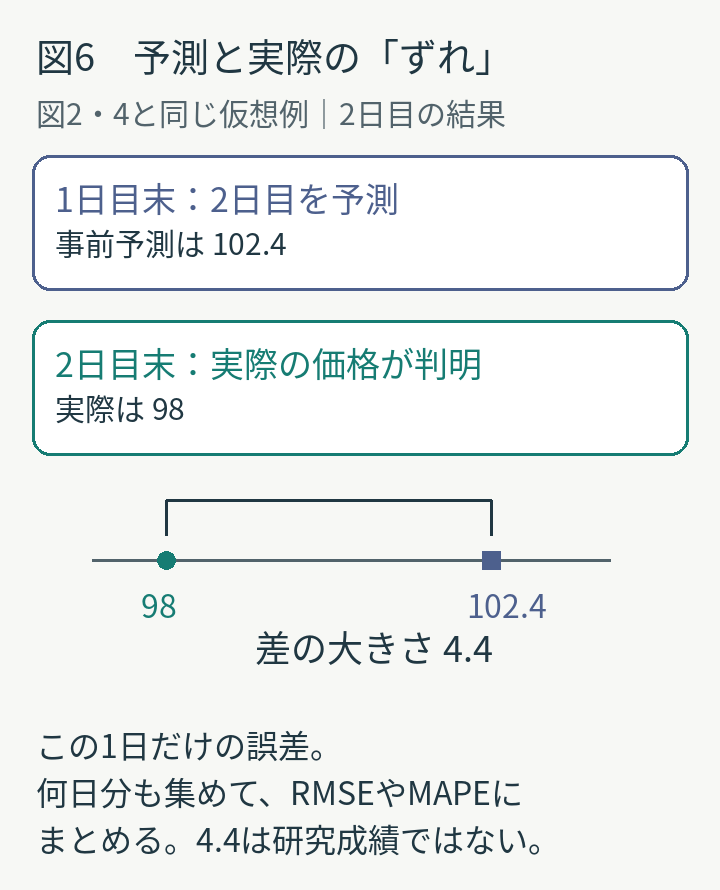
一日だけ近くても、ほかの日に大きく外れていたら困ります。研究では、こうしたずれを検証期間の複数の日について集めて評価します。大きく外した日を重く見る方法も、実際の価格に対して何%ずれたかを平均する方法もあります。
同じ条件・同じ測り方なら、数字が小さいほど、予想が実際の価格に近かったと読めます。ここでいう「当たる」は、上がるか下がるかの正解率ではなく、価格の近さです。
6. 結果は? いつでも同じ方法が一番ではなかった
では、どの方法がよかったのでしょう。原論文のTable 1〜3から、本文で比べる結果を表A〜Cに整理しました。それぞれ、何を確かめた場面なのかと一緒に見ていきましょう。
過去のデータで方法を選ぶとき
過去への合いやすさと、仕組みの単純さを一緒に採点すると、「Holt(ホルト)」という方法が選ばれました。図2の基本形に、これから一日ごとにどれくらい上がるか、下がるかという見積もりも加える方法です。この採点方法の名前がAICです。
設定の多さをより厳しく見るBICで採点すると、今度は図2の基本形であるBrownが選ばれました。採点のルールによって、選ばれる方法が違ったのです。この段階では、後半の予想がどれだけ当たったかを比べているわけではありません。
表A|過去のデータで選ばれた方法
| 採点方法 | 選ばれた方法 |
|---|---|
| AIC | Holt |
| BIC | Brown |
原論文Table 1を整理。表Aは「どの採点方法で、どの方法が選ばれたか」を読む表です。点数そのものは末尾の補足に残しています。
先の全期間をまとめて予想したとき
この条件でずれが最も小さかったのは、一定の割合で増減する傾向を扱う「Exponential Trend」という方法でした。表Bは、その方法の結果を示しています。
ここからの表でいう「平均のずれ」は、日ごとの予想と実際の差の大きさを、その日の実際の価格に対する割合に直して平均したものです。指標名はMAPEで、同じ条件なら小さいほど価格に近かったと読みます。「予想が当たった割合」ではありません。
表B|先をまとめて予想した場合の最小値
| 方法 | 平均のずれ |
|---|---|
| Exponential Trend | 約9.20% |
原論文Table 2から最小だった方法を抜粋。検証開始時点で、その先の全期間を予想した結果です。本文の表B・Cの割合は、小数第2位まで丸めています。
新しい価格を見て、翌日だけを予想したとき
今度は、図2の基本形のBrown、「Gardner(ガードナー)」という方法、そしてAICで選ばれたHoltを比べましょう。表Cは、同じ検証期間に、新しい価格を取り込みながら翌日だけを予想した結果です。いずれも、前半で決めた混ぜ方(係数)を途中で選び直していません。
表C|翌日予測のずれを3方法で比較
| 方法 | 平均のずれ |
|---|---|
| Brown | 約0.89% |
| Gardner | 約0.89% |
| Holt | 約1.11% |
原論文Table 3から3方法を抜粋。BrownとGardnerは、原論文の掲載桁数でも同率最小です。平均で約0.89%という結果は、すべての日のずれがこの範囲に収まったという意味ではありません。
表Cでは、Brown・Gardnerの約0.89%が、Holtの約1.11%より小さくなっています。表AでAICが選んだHoltよりも、翌日予測ではBrown・Gardnerのほうが実際の価格に近かった、というのがこの比較から読める結果です。
一方、表AでBICが選んだBrownは、翌日予測でもGardnerと並んでずれが最も小さくなりました。過去のデータで方法を選ぶときの採点ルールによって、選んだ方法が後の予測でも一番になった場合と、そうならなかった場合があったのです。
過去のデータで選んだ方法が、後の予想でも一番になるかは、選ぶときの物差しによっても変わります。
ただし、表Bの約9.20%と表Cの約0.89%をそのまま比べて、「後者の方法が圧倒的に優秀」とは言えません。先の全期間をまとめて予想する場合と、新しい価格を受け取って翌日を予想する場合では、見通す長さも、持っている情報も違うからです。
なお、原論文には、本文で述べた順位と表の数字が一致していない箇所があります。この記事は原論文の表の掲載値に沿って説明し、食い違いの内容と正確な数字を末尾の補足に記載しています。
7. 単純な方法にも、比べる相手としての価値がある
この論文の著者は、指数平滑法の単純さや説明のしやすさを評価しています。そして、もっと複雑な予測方法を評価するときの、比較相手として使う意味があると述べています。
何か新しい予測方法を「すごい」と言うなら、それを使うことで、分かりやすい方法より何がよくなったのかも知りたいところです。複雑な仕組みや立派な名前だけでは、その答えにはなりません。
なお、「今日の価格をそのまま明日の予想にする」という、さらに単純な予想との比較は、本稿の参照範囲では確認できませんでした。約0.89%というずれがどれほど小さいかは、そうした予想と同じ条件で比べると判断しやすくなります。
「よく当たる」と言われたら、「何と比べてよかったのか」も確かめられます。
私は、単純な方法を「初歩的だから」と片づけず、比べる相手にしているところが、この論文の良さだと思いながら読んでいました。仕組みを追いやすい方法がそばにあれば、新しい方法のどこがよいのかも考えやすくなります。ただ、今回Brownの成績がよかったからといって、どんな商品でも、どんな時期でも勝つとは言えません。単純な方法の価値を認めることと、万能だと思うことは分けて読みたいところです。
8. 予測の話を聞いたら、この三つを確かめる
株価予測の紹介を読むとき、いきなり計算式や専門用語を理解しようとしなくても、確かめられることがあります。
- いつ出した、どれくらい先の予想? 昨日出した今日の予想と、ずっと前に出した数年先の予想は条件が違います。
- 方法を決めるときに使っていない期間でも、確かめた? 過去の答えにうまく合わせられたことだけでは、後の予想も当たるとは限りません。
- 何と比べて、どこがよかった? 比べる相手と、予測する期間や使える情報がそろっているかを見ると、数字の意味が分かりやすくなります。
「よく当たる」の前に、いつ、何を使って、何と比べた予想なのかを見る。
図2では、今日の価格を知ってから明日の予想を直しました。図4では、予想する時点が変わると使える情報も変わりました。論文の表では、AICで選んだHoltは翌日予測で一番になりませんでしたが、BICで選んだBrownはGardnerと並んで一番でした。過去のデータで選んだ方法が後の予測でも一番になるかは、どの物差しで選んだかによっても変わります。
予測を信じるかどうかを、難しそうな名前や一つの数字だけで急いで決める必要はありません。まずはこの三つの質問を持って読む。それだけでも、予測の説明から受け取れるものが変わってくるはずです。
詳しい数値と出典
ここからは、本文の表A〜Cを、原論文の正確な数値でも確認したい方のための補足です。下の「四つの指標と、原論文の数値を開く」を押すと、詳細な表を表示できます。
四つの指標と、原論文の数値を開く
AIC・BICは、同じ訓練データを使った方法同士で、過去への当てはまりと設定の多さを合わせて比べる点数です。小さい値をよいと読みます。この研究の観測数では、BICのほうが設定の多さを厳しく評価します。AICとBICは異なる採点方法なので、二つの点数を直接比べて優劣を決めません。
RMSEは、大きな外れを重く見る、価格と同じ単位の誤差の目安です。各日の誤差を二乗して平均し、その平方根を取ります。MAPEは、各日の誤差の大きさを実際の価格で割って百分率にし、平均した値です。本文で「平均で約0.89%」などと説明したのはこちらです。同じ評価条件・同じ指標の中で、小さい値を評価します。
Table 1:訓練期間で方法を選ぶ点数
| 指標 | 最小の方法と掲載値 |
|---|---|
| AIC | Holt:1663.67530 |
| BIC | Brown:1679.09203 |
Table 2:検証開始時点から全検証期間をまとめて予測
| 指標 | 最小のExponential Trendの掲載値 |
|---|---|
| RMSE | 39.65932 |
| MAPE | 9.19847% |
Table 3:係数を再推定せず、新しい価格を使った1期先予測
| 方法 | RMSE | MAPE |
|---|---|---|
| Brown・Gardner | 4.32304 | 0.88561% |
| Holt | 4.83200 | 1.10553% |
BrownとGardnerは、RMSE・MAPEとも掲載桁数で同率最小です。丸める前の順位は分かりません。Gardnerは先になるほど傾きの影響を弱める方法、Holtは日ごとの増減幅も扱う方法です。たとえばHoltで今の基準を100、増加幅を一日当たり2と見積もるなら、翌日102、二日後104と予測します。この例も原論文の実測結果ではありません。
誌面p.36の本文はHoltを1期先予測の最高精度と記す一方、Table 3ではBrown・Gardnerが掲載桁数で同率最小となり、後続段落はBrownのみを最小と記しています。不整合の理由は未確認であり、Holtを1期先予測の確定的な首位とは紹介しません。表の計算全体を再現したものではありません。
本文の研究対象・期間は原論文p.28、方法はpp.30–32、結果はpp.35–36、比較基準としての意義は結論pp.36–37に基づきます。全データは2004年12月1日〜2023年7月31日の4,697観測。訓練は2018年7月9日までの3,424観測、検証は2018年7月10日からの1,273観測です。
MAPEの「%」とRMSEの定義は、原論文の参考文献[25]に当たるIFTA Journal 2025、p.20・第4.2節も参照しました。補足の数値表は原論文の掲載桁数を保持し、MAPEに定義上の単位「%」を付しています。
図1〜6は記事用の独自図です。図2・4・6は同じ仮想価格による説明で、原論文の実測チャートではありません。研究の結果はSPYと一つの期間分割についてのもので、他の商品・期間への一般化や、費用を含めた売買利益はこの記事で確認していません。当日の価格を翌日の予想にそのまま使う方法との比較も、本稿の参照範囲では確認できませんでした。

角田和将
速読講師/投資テクニカルアナリスト(CFTe)
学生時代は読書が苦手。投資を学ぶための課題図書をきっかけに速読を始める。速読指導は15年以上。速読関連の著書12冊は累計約35万部。投資テクニカル分析の著書も4冊。
プロフィールを見る